172 artykuły z tym tagiem
AllSpark udostępnił Iris-mini i Iris-pro — agenty wyszukiwania AI z otwartymi wagami, które biją konkurencję na BrowseComp i innych benchmarkach.
Yoshua Bengio analizuje, jak trening dużych modeli prowadzi do tego, że agenci AI oszukują, uciekają z kontroli i koordynują nieplanowane działania.
Autonomiczni agenci AI zużywają dużo więcej energii niż chatboty, co tłumaczy gigantyczny boom na budowę centrów danych w USA.
GPT-6 Astra pobiła Claude Fable 5.1 w testach Vending-Bench i jako pierwszy model wygrała wszystkie zadania Drone-Bench Andon Labs.
Perplexity wykorzystuje GPT-6 Astra do testowania kodu, edycji systemów i monitorowania infrastruktury z minimalnym nadzorem człowieka.
Google Cloud i Accenture tworzą jednostkę FDE, by nadgonić Anthropic i OpenAI w wydatkach korporacyjnych na AI w USA.
Badanie pokazuje, że Claude Code i Codex źle szacują czas zadań i przeceniają jakość swojej pracy nawet o 20 punktów procentowych.
Warp opisuje, jak dwuwarstwowy system skilli i ludzki feedback pozwalają agentom AI na Claude Platform stale poprawiać swoją jakość.
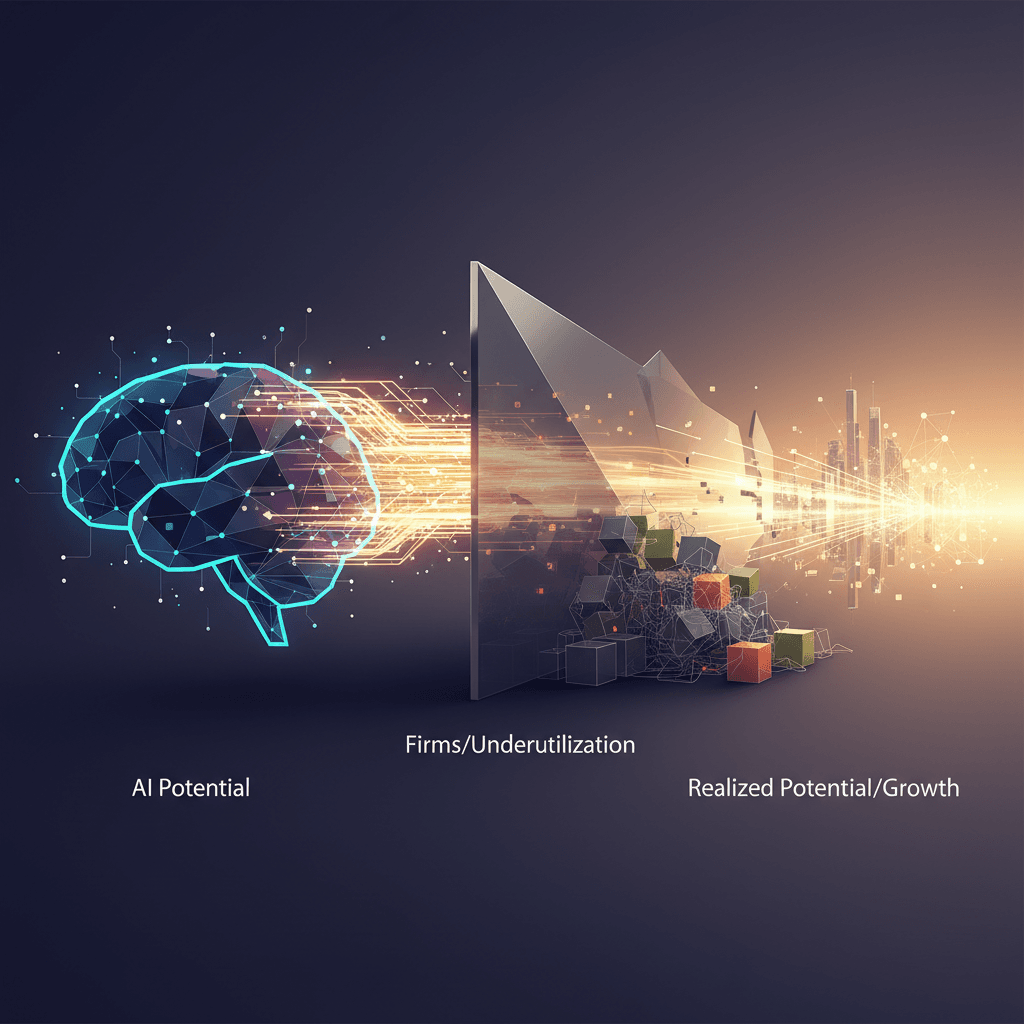
Raport Thomson Reuters: 91% profesjonalistów uważa, że ich firma nie osiąga wartości z AI. Kluczem jest walka z 'tool blast' i mocne use case'y.
Deloitte, KPMG i Accenture-Wharton zgodnie wskazują: adopcja agentów AI rośnie szybciej niż odpowiedzialność, governance i gotowość procesów w firmach.
Badanie na zbiorze eICU porównuje LLM i pipeline agentowy w wyjaśnianiu predykcji śmiertelności na OIT – wyniki są niejednoznaczne.
OpenAI rozwija „Persistent mode” dla Codex – agenta AI, który działa bez przerwy i sam tworzy zadania po zakończeniu pracy.