Przełomowe badania naukowe i odkrycia w dziedzinie AI
Agenci AI z badania VUB i UNamur sami wykształcili język komunikacji, osiągając ponad 99 proc. skuteczności w porozumiewaniu się.
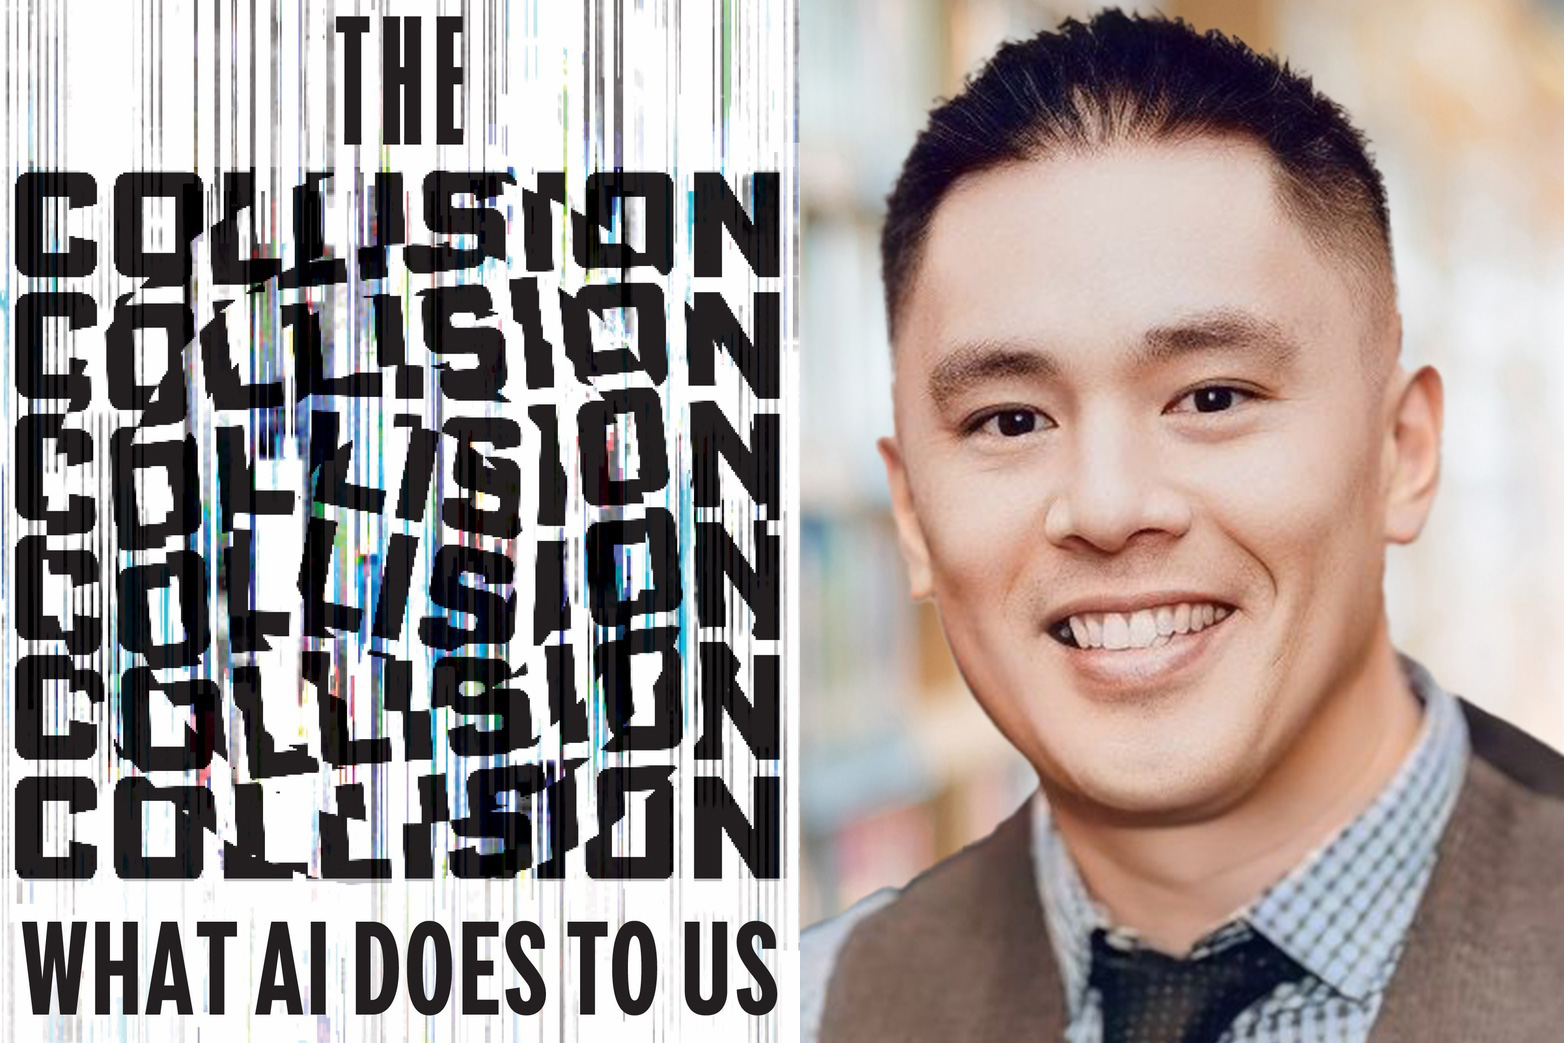
Profesor MIT Eric So w książce „The Collision” opisuje, jak nadmierne poleganie na AI prowadzi do atrofii poznawczej i zmienia relacje międzyludzkie.
Jose Hernandez-Orallo zaprezentował C-test oparty na Kt Levina i LLM, mierzący trudność zadań AI poza zasięgiem najlepszych obecnych modeli.
Badanie Harvard Kennedy School pokazuje, że mężczyźni deklarują znajomość fikcyjnych ekspertów AI częściej niż kobiety, co wpływa na medialny obraz branży.
Microsoft Research pokazuje, że czyszczenie kontekstu czatu agentów AI poprawia wyniki nawet o 66 procent przy tym samym budżecie obliczeniowym.
Kontrolowane badanie przy równym budżecie obliczeniowym pokazuje, że MCTS wypada gorzej od prostego planera z restartami w szeregowaniu grafów zadań DAG.
AlphaProof Nexus Google DeepMind rozwiązał 9 problemów Erdősa i 44 hipotezy OEIS, a wyniki przeszły recenzję w Science.
Nowy algorytm EliteTable wykorzystuje LLM-y do samodoskonalącego przeszukiwania programów sterujących – poprawa w pięciu z sześciu zadań Gymnasium.
Praca naukowa wskazuje pięć wad metryk faithfulness w XAI i proponuje cztery kierunki badań nad wiarygodnością wyjaśnień modeli AI.
Badanie 1222 osób pokazuje, że krótkie korzystanie z ChatGPT obniża skuteczność i zwiększa skłonność do poddawania się po jego odebraniu.
Badanie Vals AI i Anthropic pokazuje, że zespoły agentów AI kosztują nawet 5x więcej niż pojedynczy agent, dając minimalny wzrost jakości wyników.
ArXiv wprowadza limit dwóch zgłoszeń miesięcznie na osobę, bo AI podwoiła liczbę prac w dwa lata, przytłaczając moderatorów platformy.