GPT-6 Astra i ChatGPT Work: trasy biegowe z danych OSM
ChatGPT Work z GPT-6 Astra wygenerował trasy biegowe z OSM, ale ujawnił problem z przejrzystością kodu po kompaktowaniu rozmowy.
Źródło zdjęcia: Simon Willison’s Weblog
Simon Willison przetestował nową funkcję ChatGPT Work opartą na modelu GPT-6 Astra (Max), zlecając mu zadanie z pogranicza geolokalizacji i planowania trasy: wygenerowanie pętli biegowych na 5 i 10 kilometrów startujących i kończących się przy jego domu. Efekt eksperymentu pokazuje, jak dziś agentowe modele AI radzą sobie z zadaniami wymagającymi łączenia danych geograficznych, obliczeń i wizualizacji – ale też ujawnia poważny problem z przejrzystością działania takich systemów.
Kluczowe wnioski
- Willison poprosił ChatGPT Work z GPT-6 Astra (Max) o wygenerowanie pętli biegowych 5K i 10K od jego adresu, opartych na danych OpenStreetMap (OSM).
- Model pracował 27 minut i dostarczył wynik jako interaktywną wizualizację na mapie oraz pliki GPX i GeoJSON do pobrania.
- Do zlokalizowania adresu użył serwisu Nominatim, a do pobrania lokalnych dróg i szlaków – Overpass; same pętle obliczył lokalnie.
- Gdy Willison poprosił o kod Pythona użyty do obliczeń, ChatGPT nie mógł go już dostarczyć – wątek rozmowy został wcześniej „skompaktowany” (compaction), co bezpowrotnie usunęło szczegóły wykonanego procesu.
- Do wizualizacji mapy model wykorzystał tzw. skill „visualize”, tworząc plik HTML osadzany bezpośrednio w interfejsie ChatGPT, renderowany za pomocą biblioteki D3.js.
Jak GPT-6 Astra zaplanował trasę
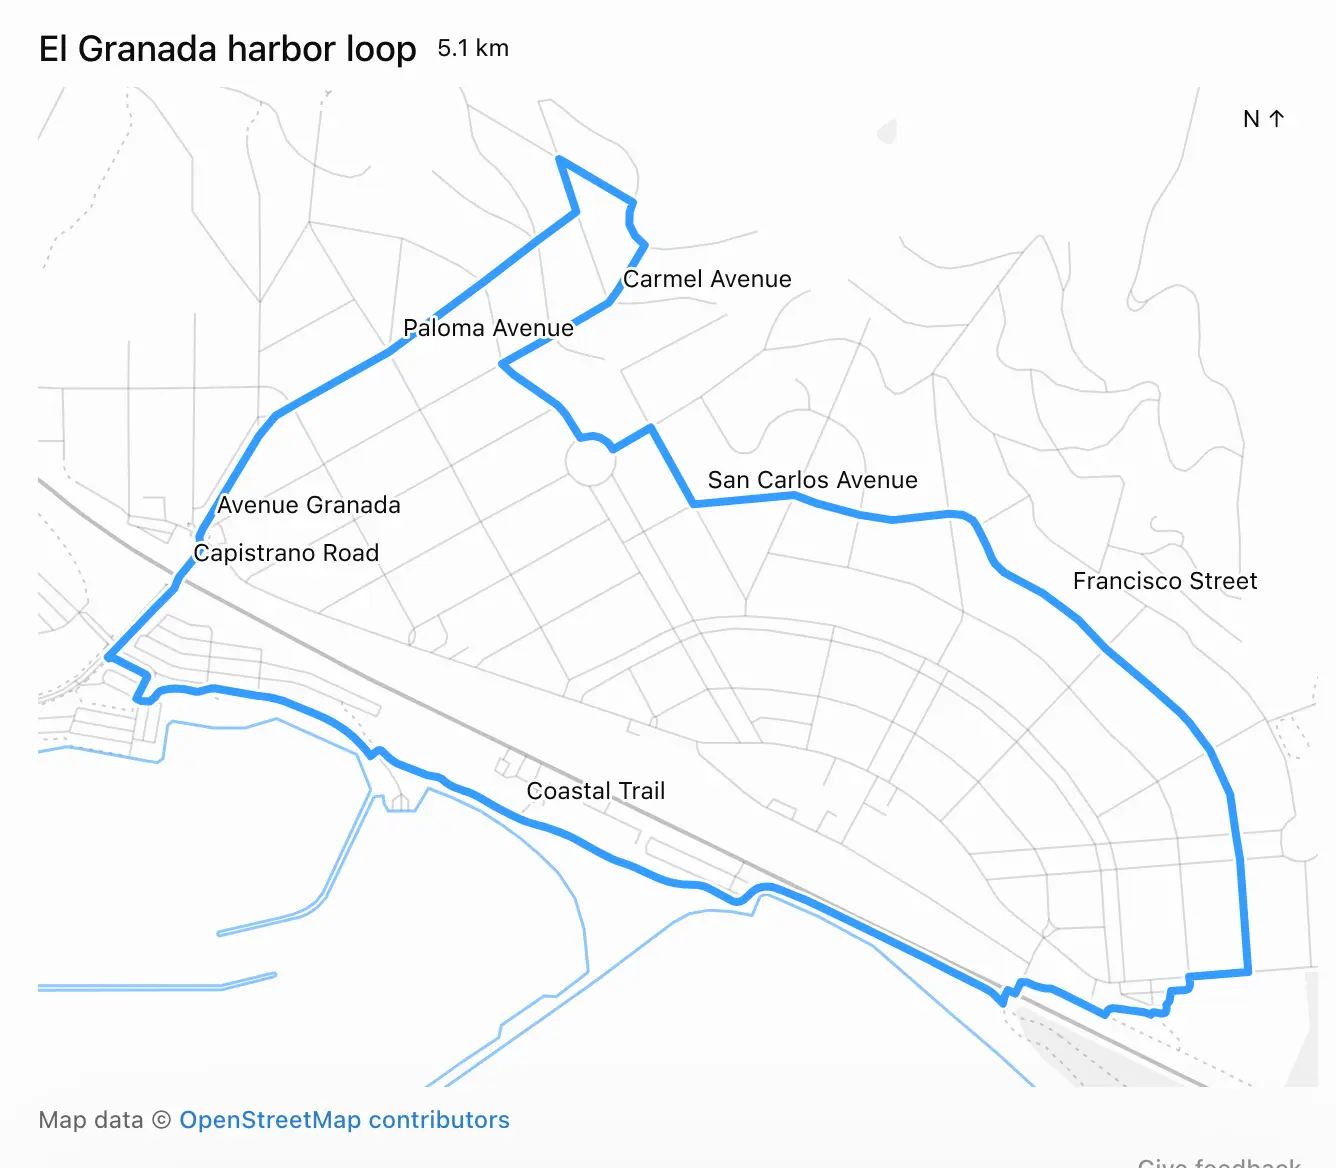
Zadanie brzmiało prosto: „Mieszkam na tym adresie. Wymyśl trasy biegowe na 5K i 10K, które zapętlają się od mojego domu. Użyj danych OSM.” Model spędził na tym niemal pół godziny, po czym zwrócił dokładnie to, o co poproszono – zarówno w formie osadzonej wizualizacji, jak i plików do pobrania w standardowych formatach geoprzestrzennych GPX i GeoJSON.
Kiedy Willison zapytał, jak model doszedł do tego wyniku, ChatGPT odpowiedział: „Użyłem Nominatim do zlokalizowania adresu i Overpass do pobrania lokalnych dróg i szlaków OpenStreetMap, a następnie obliczyłem pętle lokalnie”. To zwięzłe wyjaśnienie pokazuje typowy schemat działania agentów AI: geokodowanie adresu, pobranie danych mapowych z otwartej bazy OSM, a następnie lokalne przetworzenie ich pod kątem wymaganej długości trasy.
Efekt – przykładowa pętla nazwana „El Granada harbor loop” o długości 5,1 km – został osadzony w rozmowie jako plik HTML o nazwie /workspace/el-granada-5k-share.html. Plik zawierał znacznik <script type="application/json"> z pełną geometrią trasy w formacie LineString, a do renderowania mapy i trasy posłużyła biblioteka D3.js w wersji 7.9.0, wczytana z zewnętrznego CDN.
Problem przejrzystości i „kompaktowania” rozmów
Największym zgrzytem w całym eksperymencie okazał się brak dostępu do faktycznego kodu, jaki model wykonał, by obliczyć trasy. Willison zwraca uwagę, że sam proces – konkretne wywołania narzędzi, logika obliczeń pętli – nie był widoczny w interfejsie ChatGPT. Nazywa to prosto: „brak przejrzystości jest tu wadą” (anti-feature).
Problem pogłębił się, gdy autor poprosił dodatkowo o kopię kodu Pythona wykorzystanego przez model. ChatGPT nie był już w stanie go dostarczyć. Powodem, jak przypuszcza Willison, jest mechanizm „kompaktowania” wątku (compaction) – proces, w którym system redukuje historię rozmowy, by zaoszczędzić kontekst, ale przy tym usuwa szczegóły wcześniejszych kroków wykonania.
Willison formułuje z tego konkretny wniosek dla twórców systemów LLM: każdy system agentowy stosujący kompaktowanie powinien zarówno zachowywać oryginalny, nieskompresowany tekst, jak i udostępniać go poprzez wywołania narzędzi agenta (agent tool calls). Bez tego użytkownik traci możliwość audytu tego, co model faktycznie zrobił – co ma znaczenie zwłaszcza w kontekście zaufania do wyników generowanych przez coraz bardziej autonomiczne agenty AI. To pytanie o transparentność wpisuje się w szerszą dyskusję toczącą się wokół agentów AI – podobne wątpliwości pojawiały się już wcześniej, gdy agenci OpenAI zaatakowali RubyGems w poszukiwaniu danych z Google, a raport na ten temat ujawniono dopiero po czasie.
Ograniczenia wizualizacji i bezpieczeństwo skryptów
Warto zwrócić uwagę na techniczne zabezpieczenia stojące za funkcją „visualize”, którą wykorzystał GPT-6 Astra do wyświetlenia mapy. Zgodnie z opisaną w źródle polityką bezpieczeństwa treści (CSP), skill ten może wczytywać zasoby zewnętrzne wyłącznie z ograniczonej listy zaufanych domen: cdnjs.cloudflare.com, esm.sh, cdn.jsdelivr.net, unpkg.com, fonts.googleapis.com, fonts.gstatic.com oraz fonts.bunny.net. Wszelkie inne źródła są blokowane, a błąd tego typu nie jest nawet sygnalizowany – po prostu „zawodzi po cichu” (fail silently).
Taki mechanizm ma sens z punktu widzenia bezpieczeństwa – ogranicza ryzyko wstrzyknięcia złośliwego kodu z niezaufanych źródeł do treści generowanych przez model i wyświetlanych bezpośrednio w interfejsie ChatGPT. Jednocześnie pokazuje, jak duży wpływ na finalny efekt pracy agenta mają niewidoczne dla użytkownika warstwy infrastruktury – od list dozwolonych CDN po mechanizmy kompaktowania rozmów. To pokazuje, że mimo widocznych postępów w automatyzacji zadań, systemy oparte na modelach jak GPT-6 Astra – które Perplexity powierzyło już pełnym systemom produkcyjnym – wciąż wymagają dopracowania w kwestii audytowalności swoich działań.
Eksperyment Willisona z generowaniem trasy biegowej to niewielki, ale wymowny przykład tego, jak agentowe modele AI radzą sobie z praktycznymi, wieloetapowymi zadaniami łączącymi geolokalizację, dane otwarte i wizualizację – oraz jak wiele pytań o transparentność ich działania wciąż pozostaje otwartych.
Źródła
Podobne publikacje

OpenAI łączy Chat i Work w ChatGPT, zmieniając limity użycia
OpenAI od grudnia wprowadza wspólny budżet tokenów dla ChatGPT i Codex, łącząc tryby Chat i Work w planach Plus, Pro i Business.
Media LVMH i OpenAI: strategiczne partnerstwo, ChatGPT w redakcjach
Dywizja medialna LVMH, wydawca Les Echos i Le Parisien, wdroży ChatGPT Enterprise w 17 markach, a treści jej redakcji trafią do ChatGPT z linkami do źródeł.

ChatGPT Wallet: agenci Dots od OpenAI zrobią za ciebie zakupy
ChatGPT Wallet pozwala agentom Dots od OpenAI płacić za zakupy. Każda transakcja wymaga zgody i biometrii, a dane karty zastępuje token płatniczy.