CheMeleon z MIT przewiduje właściwości cząsteczek przy niewielu danych
CheMeleon, otwarty model bazowy z MIT, przewiduje właściwości cząsteczek na podstawie niewielu danych. Już korzystają z niego firmy farmaceutyczne. Jak działa?
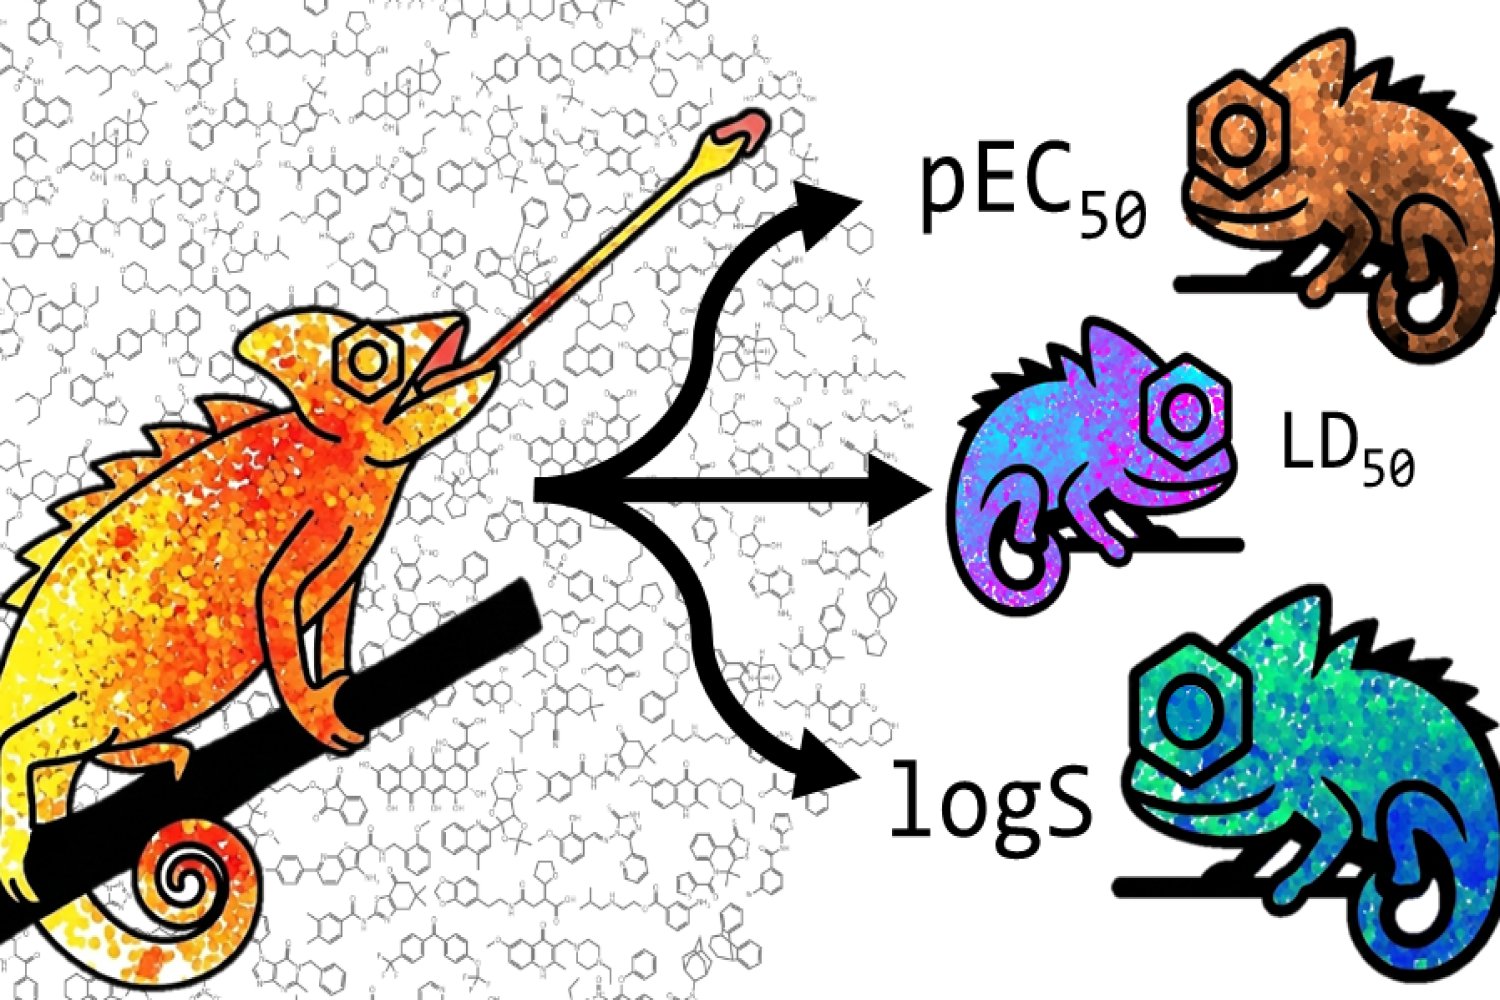
Źródło zdjęcia: MIT News | Massachusetts Institute of Technology
MIT opracował model uczenia maszynowego, który przewiduje właściwości cząsteczek nawet wtedy, gdy danych eksperymentalnych jest bardzo mało. Narzędzie nazywa się CheMeleon i, jak podaje MIT News w artykule o przewidywaniu zachowania cząsteczek, ma ułatwić projektowanie nowych leków i innych substancji przy znacznie mniejszej liczbie drogich eksperymentów. Model jest open-source. Zanim jego opis przeszedł recenzję naukową, korzystało z niego już kilka firm farmaceutycznych.
Wyniki opublikowano w numerze „Journal of Chemical Information and Modeling” z 14 września. Praca nosi tytuł „Deep learning foundation models for low-data regimes from classical molecular descriptors”. Autorami są naukowcy z MIT oraz trzej badacze z koncernu chemicznego BASF.
Najważniejsze informacje
- CheMeleon to wstępnie wytrenowany model bazowy (foundation model) dla chemii. Uczy się na deskryptorach molekularnych około miliona cząsteczek z bazy PubChem, którą prowadzą amerykańskie Narodowe Instytuty Zdrowia (NIH).
- Model sprawdza się przy niewielkiej liczbie danych. Wystarczy kilka punktów pomiarowych, by dostroić go do konkretnego zadania, na przykład przewidywania rozpuszczalności, toksyczności czy aktywności biologicznej.
- W 58 przypadkach testowych CheMeleon wypadł najlepiej w porównaniu z innymi modelami bazowymi i z klasycznymi modelami opartymi na wiedzy ekspertów.
- W konkursie OpenADMET dziewięć z dwudziestu najlepszych zgłoszeń wykorzystywało CheMeleon.
- Model jest otwarty. Każdy może go pobrać za pośrednictwem pakietu ChemProp i dostroić do własnych potrzeb.
Problem: chemia wciąż opiera się na próbach i błędach
Poszukiwanie nowych cząsteczek o określonych zastosowaniach napędza postęp w wielu branżach. Firmy farmaceutyczne szukają nowych leków, a producenci elektroniki i przedsiębiorstwa energetyczne potrzebują materiałów o konkretnych właściwościach. Proces ten w dużej mierze nadal polega jednak na metodzie prób i błędów. Nie istnieje sposób, by dokładnie przewidzieć, jak dany związek zachowa się pod względem wielu różnych właściwości i reakcji.
W ostatnich latach coraz częściej sięga się po sztuczną inteligencję i uczenie maszynowe. Mają one uzupełniać lub przyspieszać żmudne obliczenia oparte na zasadach fizyki, podobnie jak w innych dziedzinach nauki, gdzie AI kalibruje modele turbulencji oceanicznej. Takie narzędzia dają przynajmniej wstępną wskazówkę, które związki warto zsyntetyzować i przetestować.
Nowa metoda z MIT jest szczególnie przydatna wtedy, gdy danych o interesującej właściwości jest niewiele. Przykładem jest powinowactwo ligandów do niedawno odkrytego celu komórkowego potencjalnego leku. W takich sytuacjach CheMeleon lepiej niż inne metody zawęża pulę cząsteczek wartych dalszej analizy.
Jak działa CheMeleon
Kluczowe jest wstępne trenowanie modelu na szczegółowych danych o milionie różnych cząsteczek. Model uczy się w ten sposób korelacji między strukturą cząsteczki a jej zachowaniem w odniesieniu do katalogu około 1600 deskryptorów, które chemicy rozwijali przez dziesięciolecia. Następnie można go dostroić do przewidywania znanych właściwości, takich jak rozpuszczalność czy lepkość. Równie dobrze nadaje się do bardziej specjalistycznych zadań, na przykład oceny bioaktywności lub reaktywności wobec konkretnego białka czy enzymu.
Milion cząsteczek to znikomy ułamek wszystkich sposobów, na jakie mogą łączyć się atomy. Wystarcza to jednak, by system AI samodzielnie wychwycił wiele ukrytych wzorców i zależności, a potem zastosował je do nowej, nieznanej cząsteczki.
Akshat Shirish Zalte, doktorant MIT i współautor pracy, wyjaśnia, czym to podejście różni się od innych:
„Większość dzisiejszych modeli głębokiego uczenia wymaga więcej danych niż metody tradycyjne.”
Niektóre skuteczne modele korzystają z obszernych danych z literatury naukowej publikowanej w czasopismach chemicznych. Zespół MIT poszedł inną drogą:
„W ogóle nie zaglądamy do literatury. Po prostu obliczamy zestaw deskryptorów molekularnych, takich jak masa cząsteczkowa czy liczba atomów tlenu.”
Przewidywanie tych łatwych do wyliczenia deskryptorów jest zadaniem, na którym model uczy się w fazie wstępnego treningu.
Inspiracja modelami językowymi
CheMeleon jest wstępnie wytrenowanym modelem bazowym. Twórcy inspirowali się znanymi modelami językowymi, takimi jak ChatGPT i Claude, które powstają dzięki karmieniu ich ogromnymi ilościami informacji z internetu. W przypadku CheMeleona rolę „internetu” pełnią deskryptory miliona cząsteczek z PubChem, dużej i bezpłatnie dostępnej bazy informacji chemicznych.
Inaczej działają klasyczne modele eksperckie. W nich specjaliści ręcznie wprowadzają szczegółową wiedzę o danej dziedzinie. Z eksperymentów wiadomo na przykład, że rozpuszczalność może zależeć od konkretnych deskryptorów cząsteczki, „takich jak masa cząsteczkowa, liczba obecnych atomów tlenu albo to, jak bardzo rozgałęziona czy masywna jest cząsteczka” – mówi Zalte.
Zespół MIT wychodzi od istniejącej architektury sieci neuronowej i uczy ją ogólnych zasad:
„Nie trenujemy go pod konkretną właściwość, lecz jako ogólny model, który rozumie chemię w pewnym stopniu. Dzięki temu nawet jeśli dostroisz go tylko kilkoma punktami danych do interesującego cię zadania, nadal możesz uzyskać dobre wyniki.”
Według Zaltego model „nie musi uczyć się wszystkiego od zera”.
Wyniki i reakcja branży
Aby sprawdzić przydatność modelu, badacze porównali go z innymi dostępnymi modelami bazowymi oraz z klasycznymi modelami opartymi na zasadach opracowanych przez ekspertów. W 58 przypadkach testowych, jak mówi Zalte, „nasz model wychodzi na prowadzenie”.
Profesor William Green, kierownik grupy i Hoyt Hottel Professor of Chemical Engineering na MIT, podkreśla praktyczne znaczenie tego wyniku:
„Model bazowy CheMeleon drastycznie zmniejsza liczbę cząsteczek, które trzeba przetestować eksperymentalnie, aby trafnie przewidzieć właściwości nowych cząsteczek. To ogromna przewaga, ponieważ synteza i testowanie dużej liczby cząsteczek są powolne i kosztowne.”
Wcześniejsza wersja pracy jest dostępna w sieci od ubiegłego roku i szybko zwróciła uwagę przemysłu. Na początku tego roku organizacja OpenADMET zorganizowała konkurs na przewidywanie właściwości nowych, wcześniej niesyntetyzowanych cząsteczek. „To był duży konkurs, wzięło w nim udział mnóstwo osób” – wspomina Green. Po ogłoszeniu wyników okazało się, że dziewięć z dwudziestu najlepszych zgłoszeń korzystało z CheMeleona.
„Zaczęliśmy więc dostawać przeróżne zapytania od firm farmaceutycznych, a nasza praca dopiero co została złożona. Nie przeszła jeszcze żadnej recenzji” – mówi Green.
W czasie recenzji model zyskiwał kolejnych użytkowników. Co najmniej jedna firma farmaceutyczna, jak relacjonuje Green, rozesłała do pracowników komunikat: „Za każdym razem, gdy modelujecie jakąś właściwość, zaczynajcie od CheMeleona. To nasza nowa polityka firmowa”. Chodziło o wstępne decyzje dotyczące tego, którymi cząsteczkami warto się zająć.
Zespół i otwarty kod
CheMeleon zbudowano na bazie ChemProp, otwartego pakietu do uczenia maszynowego, który również rozwija i utrzymuje grupa Greena na MIT. Za jego pośrednictwem każdy może pobrać CheMeleona i dostroić go do własnych zastosowań.
Autorami publikacji są:
- Akshat Shirish Zalte, doktorant MIT,
- Jackson Burns, świeżo wypromowany doktor MIT (PhD ’26),
- Charlles Abreu, pracownik naukowy MIT,
- prof. William Green z MIT,
- Jochen Sieg, Christian Feldmann i Miriam Mathea z BASF SE w Niemczech.
Badania wsparło konsorcjum Machine Learning for Pharmaceutical Discovery and Synthesis, a stypendia zapewniły Departament Energii USA oraz MathWorks.
Co to oznacza dla Polski
CheMeleon jest modelem open-source dostępnym przez pakiet ChemProp, więc nie ma barier związanych z dostępnością w Polsce. Mogą go pobrać i dostroić zarówno zespoły akademickie, jak i firmy farmaceutyczne czy chemiczne. Największą korzyść odniosą ci, którzy dysponują niewielkimi zbiorami danych eksperymentalnych, bo właśnie z myślą o takich sytuacjach zaprojektowano to narzędzie. W pracach nad modelem uczestniczyli badacze z niemieckiego BASF, co pokazuje, że rozwiązanie powstało również przy udziale europejskiego przemysłu chemicznego.
Podsumowanie
CheMeleon pokazuje, że logikę modeli bazowych znaną z AI językowej można z powodzeniem przenieść do chemii. Wystarczy trening na łatwo obliczalnych deskryptorach, a nie na literaturze naukowej. Otwarty kod, wyniki w 58 testach i popularność wśród uczestników konkursu OpenADMET sprawiają, że narzędzie już teraz wpływa na to, jak przemysł farmaceutyczny wybiera cząsteczki do dalszych badań.
Źródła
Podobne publikacje
Barzilay i Collins z Nagrodą Pritzkera za antybiotyki odkryte przez AI
Regina Barzilay i James Collins z MIT otrzymali Nagrodę Pritzkera 2026 za odkrywanie antybiotyków z pomocą AI, w tym halicyny – pierwszego leku tego typu.

AI wykrywa choroby drzew oliwnych dzięki generowaniu danych
Naukowcy łączą CutMix, MixUp i DCGAN, by poprawić klasyfikację chorób drzew oliwnych modelem EfficientNetV2B0 i wzbogacić rolnictwo precyzyjne.

Carbon-X od Hugging Face: model AI do rozmowy z DNA
Hugging Face wypuściło Carbon-X – otwarty model AI do rozmowy z DNA, działający lokalnie i pomagający badać mutacje genetyczne.