6 min czytania
Cathy Wu z MIT: uczenie ze wzmocnieniem dla transportu
Profesor MIT Cathy Wu wykorzystuje uczenie ze wzmocnieniem, by projektować lepsze systemy transportowe, po latach porażek osiągając 30-krotny wzrost efektywności treningu.
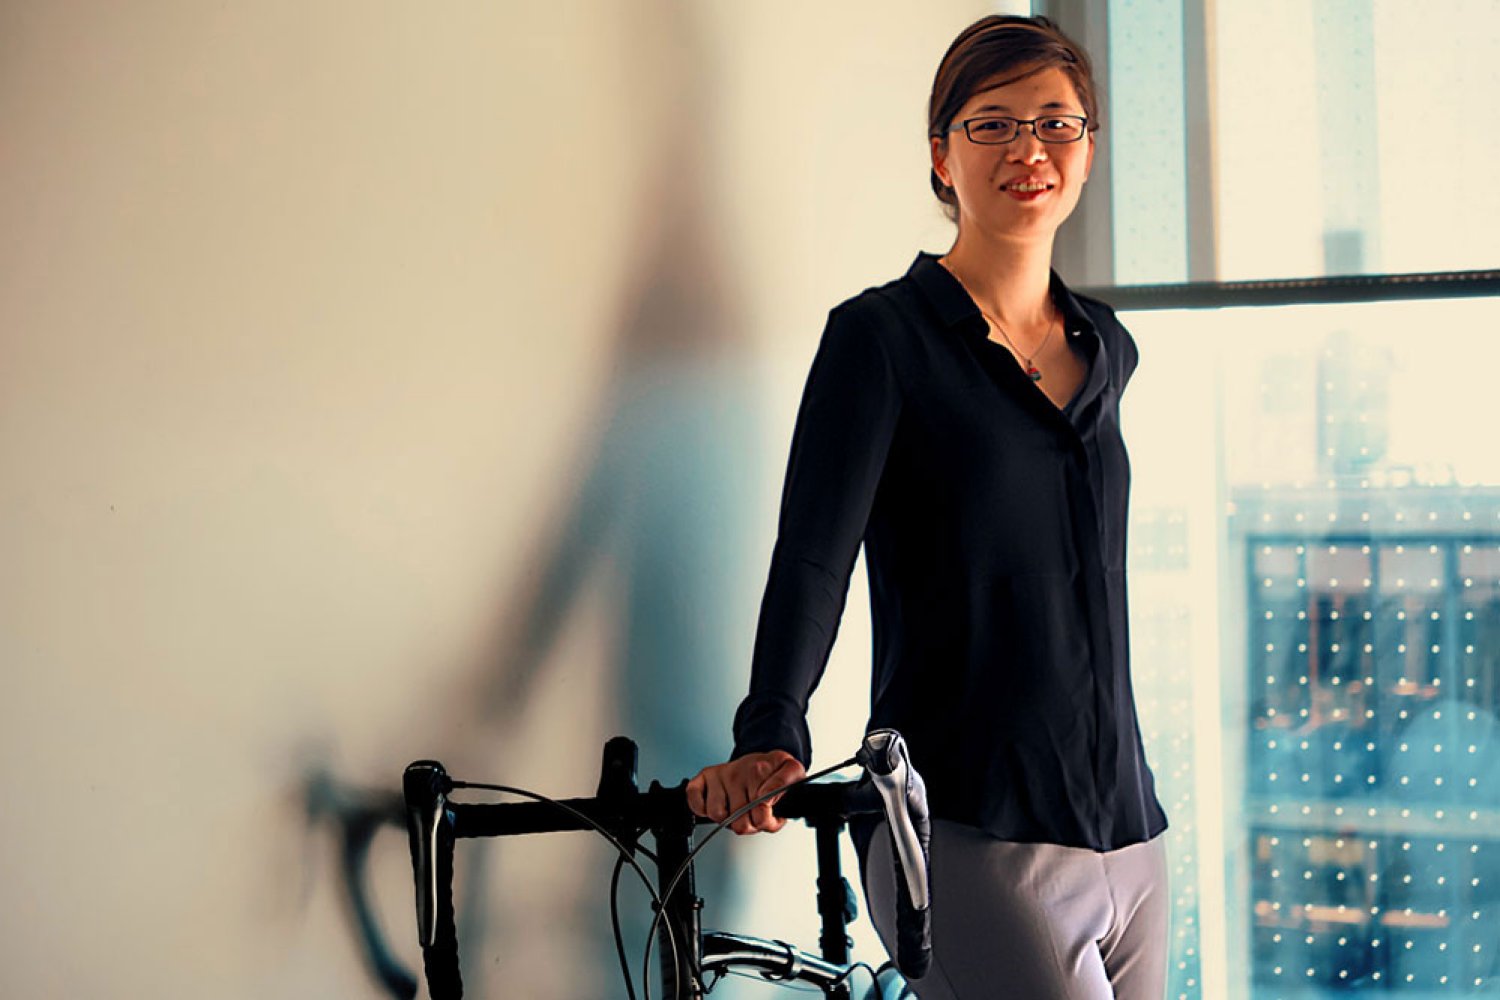
Źródło zdjęcia: MIT News | Massachusetts Institute of Technology
Cathy Wu, profesor nadzwyczajna na Massachusetts Institute of Technology, wykorzystuje uczenie ze wzmocnieniem (reinforcement learning, RL), by rozwiązywać jedne z najbardziej złożonych problemów społecznych – przede wszystkim te związane z transportem. Jej droga do tego celu zaczęła się daleko od laboratoriów MIT: od codziennych, długich dojazdów ojca do pracy i gier komputerowych, w które grała z rodzeństwem jako dziecko.
Wu jest profesorem nadzwyczajnym w Departamencie Inżynierii Cywilnej i Środowiskowej (CEE) oraz w Instytucie Danych, Systemów i Społeczeństwa (IDSS) na MIT, a także głównym badaczem w Laboratorium Informacji i Systemów Decyzyjnych. Jej zespół rozwija metody uczenia maszynowego i uczenia ze wzmocnieniem, które mają pomóc projektować bardziej efektywne i bezpieczne systemy transportowe.
Kluczowe wnioski
- Cathy Wu, absolwentka MIT (inżynieria licencjacka 2012, magisterska 2013), kieruje badaniami nad zastosowaniem uczenia ze wzmocnieniem (RL) do projektowania systemów transportowych.
- W 2018 roku, w ostatnim roku doktoratu na University of California w Berkeley, Wu po raz pierwszy skutecznie zastosowała RL do analizy wpływu autonomicznych pojazdów na przepływ ruchu w różnych sieciach transportowych – badanie to zyskało szeroki rozgłos.
- Kolejne dwa lata przyniosły serię niepowodzeń w próbach zastosowania RL do problemów transportowych, co Wu określa jako „stresujące”, bo nie było jasne, czy problem leży w metodzie, w domenie transportu, czy w samej technologii RL.
- W 2023 roku zespół Wu opracował algorytm, który zwiększył efektywność treningu modeli RL nawet 30-krotnie – to, co normalnie wymagałoby 100 modeli treningowych, można teraz uzyskać za pomocą trzech.
- Wu podkreśla, że wpływ społeczny badań naukowych jest „przedsięwzięciem na całe życie”, nie czymś, co da się osiągnąć w ciągu kilku lat.
Od dziecięcych dojazdów do SimCity: korzenie motywacji badawczej
Cathy Wu, córka tajwańskich imigrantów, od najmłodszych lat chciała znajdować sposoby rozwiązywania problemów, które poprawiałyby życie ludzi. Jej ojciec miał długi dojazd do pracy, co zabierało mu czas, który mógłby spędzać z rodziną. Ze względu na ograniczony budżet rodzina często pozostawała w domu, na ulicy zbyt ruchliwej, by dzieci mogły bezpiecznie bawić się na zewnątrz. W efekcie Wu i jej rodzeństwo spędzali dużo czasu, grając w gry komputerowe, między innymi w „SimCity”.
Jak sama mówi, to właśnie chęć zmieniania świata na lepsze, codzienna walka ojca z korkami oraz symulacyjne gry stały się zarodkiem jej motywacji do projektowania bezpiecznych i efektywnych systemów transportowych. Wu podkreśla również wpływ starszej siostry, która zaszczepiła w niej pragnienie poprawiania życia innych ludzi.
„Lubię transport, bo łączy wszystkich. Wszyscy go używamy, wszyscy go doświadczamy, wszyscy mamy z nim problemy. Więc na pewnym poziomie wszyscy jesteśmy zainteresowani tym, żeby ten system był lepszy” – mówi Wu.
Zainteresowanie zastosowaniem sztucznej inteligencji w transporcie Wu rozwinęła jeszcze na studiach licencjackich na MIT, po wykładzie na temat autonomicznych pojazdów wygłoszonym przez nieżyjącego już profesora Setha Tellera. Wykład odbył się w ramach zawodów robotyki podczas Independent Activities Period – zawodów, które Wu wygrała. To wydarzenie, jak sama twierdzi, ukształtowało jej podejście do badań transportowych. Zaczęła współpracować z Tellerem, a gdy ten przestał się koncentrować na autonomicznych pojazdach, zachęcił ją do przejścia do grupy profesor Danieli Rus, która prowadziła badania nad robotaksówkami. Wu wspomina z wdzięcznością osoby, które pomogły jej odkryć te zainteresowania – wymienia Tellera, Rus oraz „przyjaciół z Dropboxa”, którzy zaprosili ją na drugi staż poświęcony zagadnieniom transportowym.
Lata porażek przed kluczowym przełomem w uczeniu ze wzmocnieniem
Po uzyskaniu stopnia magistra na MIT, Wu rozpoczęła doktorat na University of California w Berkeley. Zauważyła tam, że badacze transportu spędzali lata na opracowywaniu metod optymalizacyjnych do modelowania i analizowania pojedynczego, nowego warianta systemu. Jej podejście jako informatyczki, rozwijającej metodologie RL i optymalizacji do rozwiązywania problemów transportowych, obiecywało wykładniczy wzrost efektywności tych analiz.
W 2018 roku, w ostatnim roku doktoratu, Wu skutecznie zastosowała RL do problemu transportowego: automatycznej analizy potencjalnego wpływu autonomicznych pojazdów na przepływ ruchu w różnych sieciach drogowych. Badanie rozprzestrzeniło się wiralowo.
Choć mogło to być momentem „resztę historii już znacie”, RL okazało się trudnym partnerem. Wu pracowała nad teorią RL podczas stażu podoktorskiego w Microsoft, a potem wróciła na MIT jako wykładowczyni, przyciągnięta – jak sama mówi – zorientowaniem CEE na zrównoważony rozwój oraz naciskiem IDSS na wprowadzanie nauki o danych do innych dziedzin.
Jednak przez kolejne dwa lata jej dalsze próby zastosowania RL do problemów ruchu drogowego zawodziły. „To było stresujące” – mówi Wu – „nie było jasne, czy problem leży we mnie (jako promotorce), w moich studentach, w domenie transportu, czy w samym RL”.
Mimo to wcześniejsze badania pozostały dowodem koncepcji – potwierdzeniem, że RL można zastosować do systemów transportowych. W 2022 roku Wu i jej studenci odkryli, że algorytmy RL są tak wrażliwe, że algorytm działający na jednym problemie może nie działać nawet na bardzo zbliżonym problemie. Kluczowy wynik, z którego Wu jest najbardziej zadowolona – „bo był jak światło na końcu długiego tunelu negatywnych wyników” – nadszedł w 2023 roku.
Przełom: jak 10 procent danych wystarczyło, by nauczyć resztę
Zespół Wu znalazł sposób na obejście wrażliwości algorytmów RL. Badacze odkryli, że choć RL może nie trenować się dobrze na 90 procentach grupy problemów, może trenować się bardzo dobrze na pozostałych 10 procentach. Trenując modele RL na tych problemach, które dają się rozwiązać i dobrze generalizują, uzyskane modele – zbiorczo – działają skutecznie na całym zbiorze powiązanych problemów, w tym na tych, które nie zostałyby rozwiązane przez bezpośredni trening.
Zespół opracował algorytm, który wskazuje, na jakich problemach warto trenować modele RL. Zastosowanie tego algorytmu zwiększyło efektywność treningu nawet 30-krotnie – oznacza to, że zamiast 100 modeli treningowych potrzebnych normalnie, wystarczą zaledwie trzy.
„Ta praca przywróciła mi przekonanie, że uczenie ze wzmocnieniem może odgrywać istotną rolę w rozwiązywaniu trudnych problemów optymalizacyjnych, w tym w transporcie” – mówi Wu. „Teraz dobra część mojej grupy pracuje nad tematem kontekstowym [uczenia ze wzmocnieniem]”.
Podejście Wu dobrze obrazuje jej szersze podejście do badań z realnym wpływem społecznym. Jak sama podsumowuje: „Wpływ społeczny jest przedsięwzięciem na całe życie, nie czymś, co da się osiągnąć w ciągu kilku lat. Potrzeba lat, żeby naprawdę zrozumieć, co się dzieje i gdzie są rzeczywiste problemy. W tym czasie staraj się być pomocny. Bądź ciekawy. Zadawaj wiele pytań”.
Historia Cathy Wu pokazuje, że rozwój technologii, które mają realnie poprawić codzienne życie ludzi – jak systemy transportowe – rzadko bywa linią prostą. Lata porażek, wrażliwość algorytmów i niepewność co do źródła problemów mogą poprzedzać przełom, który w efekcie potrafi radykalnie przyspieszyć badania naukowe, jak w przypadku jej algorytmu zwiększającego efektywność treningu RL nawet 30-krotnie.
Źródła
Powrót do nawigacji
Podobne Publikacje

Biznes i Rynek
Kevin Roose o książce AGI Chronicles i nowym podcaście Machine Gods
Kevin Roose opowiada o książce AGI Chronicles, 150 wywiadach z branżą AI i nowym podcaście Machine Gods z NPR.
6 min
Narzędzia i Aplikacje
Asus ProArt z RTX Spark: lokalna AI zamiast ChatGPT i chmury
Asus ProArt z Nvidia RTX Spark ma uruchamiać lokalnie agentów AI, zastępując chmurowe usługi i płatne abonamenty na komputerze.
6 min

Biznes i Rynek
Deepseek zbiera 12 mld dolarów przed IPO w 2027 roku
CATL i Tencent inwestują w rundę Deepseek wartą do 15 mld dolarów. Chiński startup AI planuje debiut giełdowy na początku 2027 roku.
5 min