148 artykułów z tym tagiem
Nowa metoda Google Cloud AI Research, RRSI, ogranicza przeuczanie agentów AI na testach i poprawia wyniki na nieznanych zadaniach przy niższych kosztach.
Fizyk z Harvardu zbudował BootLoops — open-source'owe narzędzie, które pozwala Claude wykonywać precyzyjne obliczenia naukowe w 18 dziedzinach.
Anthropic wydał Claude Sonnet 5.5 – szybszy o 30%, tańszy o 30% i niemal równy Opus 5.5 na kluczowych benchmarkach programistycznych.
Nowy benchmark Epoch AI pokazuje, że GPT-6 Astra rozpoznaje błędy montażu mebli IKEA z 80% dokładnością wobec 28% jeszcze 10 miesięcy temu.
Anthropic wypuściło Opus 5.5 — tańszy i szybszy model, który w testach dorównuje większemu Fable i respektuje zabezpieczenia poziomu Mythos.
Anthropic otwiera fizyczne laboratorium biologiczne, w którym Claude kieruje robotami w eksperymentach nad nowymi lekami na choroby nieuleczalne.
Grok 4.7 od xAI kosztuje mniej niż konkurenci, ale benchmarki pokazują wyraźny dystans do Claude Fable 5.1 i GPT-6, zwłaszcza w kodowaniu.
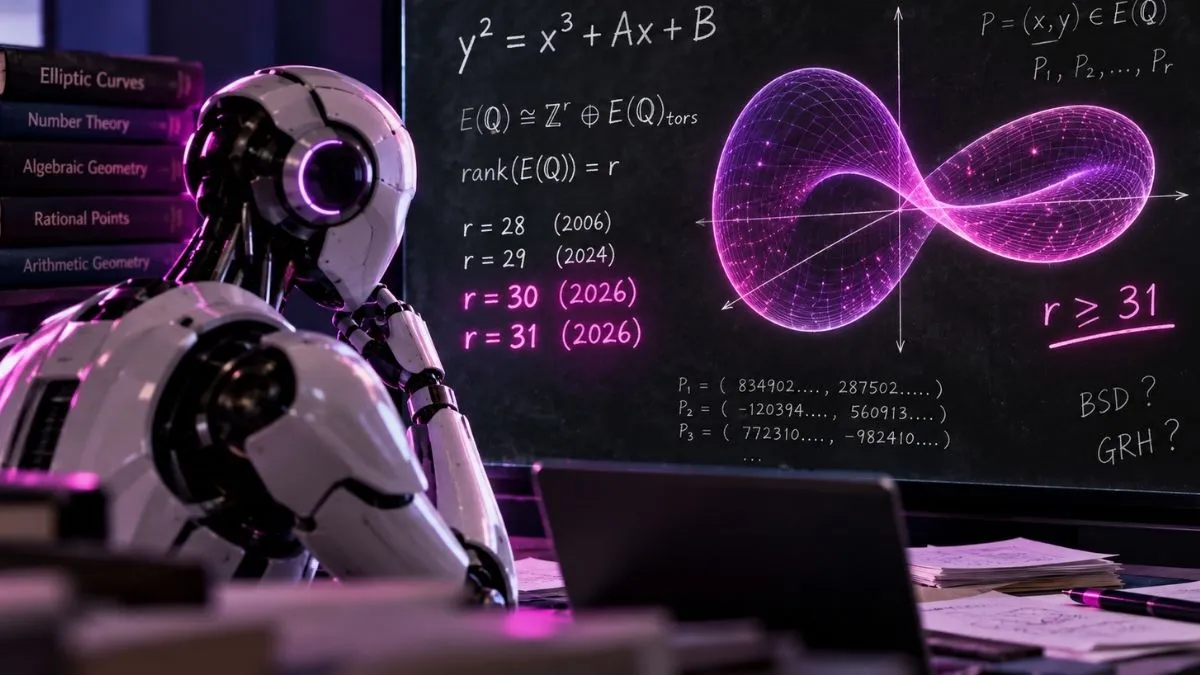
Claude z matematykami znalazł krzywą eliptyczną rangi co najmniej 31, bijąc rekord, który wcześniej rósł przez 18 lat pracy naukowców.
Anthropic scala Claude Cowork z czatem i wprowadza Claude Docs, tworząc jedno wszechstronne narzędzie do pracy i dokumentów.
Anthropic scala Claude Chat i Cowork, dodając Claude Docs i Slides – Claude sam rozpozna, czego wymaga zadanie użytkownika.
GPT-6 Astra pobiła Claude Fable 5.1 w testach Vending-Bench i jako pierwszy model wygrała wszystkie zadania Drone-Bench Andon Labs.
Nowy raport Anthropic ujawnia skalę nadużyć Claude – od hakerów sponsorowanych przez państwa do prób opracowania broni biologicznej.