6 min czytania
NVIDIA i AI4Bharat: 2,8 biliona tokenów dla 22 języków Indii
NVIDIA i AI4Bharat udostępniają Nemotron-pretraining-Indic-v1 – 2,8 biliona tokenów i otwarty potok generowania danych dla 22 języków indyjskich.

Źródło zdjęcia: huggingface.co
AI4Bharat i NVIDIA ogłosiły wspólne wydanie Nemotron-pretraining-Indic-v1 — zbioru danych treningowych liczącego około 2,8 biliona tokenów w 22 językach indyjskich. Razem z korpusem udostępniony zostanie otwarty, przyspieszany na GPU potok do generowania danych, który posłużył do jego stworzenia. Projekt powstał przy współpracy NVIDIA z IIT Madras, czołową indyjską uczelnią techniczną, oraz jej laboratorium AI4Bharat.
22 języki objęte projektem to te wymienione w konstytucji Indii — pierwszy język dla 97% mieszkańców kraju, czyli niemal 1,2 miliarda obywateli według spisu powszechnego z 2011 roku. Celem inicjatywy jest dostarczenie twórcom modeli znacznie większych zasobów do pretreningu w językach indyjskich, które do tej pory wyraźnie ustępowały zasobom anglojęzycznym.
Kluczowe wnioski
- Nemotron-pretraining-Indic-v1 to zbiór około 2,8 biliona tokenów obejmujący 22 języki indyjskie, w tym dane w piśmie natywnym dla wszystkich 22 języków i w transkrypcji łacińskiej (romanizacji) dla dwunastu z nich.
- Korpus zawiera 2601,0 miliarda tokenów w piśmie natywnym oraz 224,6 miliarda tokenów zromanizowanych (liczonych tokenizerem Gemma-4), rozłożonych na 34 konfiguracje język-pismo.
- Dane powstały z 15 podzbiorów Nemotron-CC-v2 — tekstów z sieci, treści pytanie-odpowiedź, materiałów matematycznych, kodu i innych treści specjalistycznych — przetłumaczonych i zweryfikowanych za pomocą NeMo Data Designer, otwartego narzędzia NVIDIA do generowania danych syntetycznych.
- Każdy wygenerowany rekord zachowuje identyfikator źródłowego dokumentu, co pozwala prześledzić dowolny fragment tekstu z powrotem do oryginału i ułatwia audyt danych.
- Potok danych już posłużył do kontynuowanego pretreningu modelu Nemotron 3.5 Super VL, do którego dodano 10 miliardów tokenów indyjskich z dwunastojęzycznego podzbioru korpusu oraz naturalnie powstałych tekstów.
Dlaczego brakowało danych dla języków indyjskich
Problem, który adresuje ten projekt, trafnie podsumował Mitesh Khapra, szef AI4Bharat umieszczony na liście TIME100 AI z 2025 roku. Jak wskazuje, technologia językowa dla indyjskich języków pozostaje w tyle za angielskojęzycznymi rozwiązaniami, ponieważ „nie mamy wystarczającej ilości danych dla języków indyjskich”. AI4Bharat, laboratorium badawcze IIT Madras zajmujące się językami Indii, od lat buduje otwarte zbiory danych i modele dla tych języków — wcześniej opracowało między innymi Sangrahę, otwarty korpus pretreningowy obejmujący 22 języki indyjskie, który stał się fundamentem badań nad otwartymi modelami językowymi dla regionu.
Nowe wydanie stanowi istotne rozszerzenie dostępnej dla społeczności otwartej, syntetycznej puli danych treningowych w językach indyjskich. Wprowadza do tych języków szeroki zestaw starannie wyselekcjonowanych materiałów anglojęzycznych — w tym treści matematyczne, kod oraz materiały pytanie-odpowiedź — dając zespołom budującym modele więcej surowca do trenowania systemów, które potrafią tłumaczyć pojęcia techniczne, rozwiązywać problemy i odpowiadać na pytania właśnie w tych językach. Każdy rekord odwołuje się do konkretnego dokumentu źródłowego, a wynik jest weryfikowany względem wejścia, dzięki czemu tekst syntetyczny pozostaje osadzony w realnych informacjach.
Struktura korpusu i proces jego budowy
Korpus dzieli się na dwie grupy konfiguracji językowych. Dane w piśmie natywnym i jednocześnie zromanizowane obejmują: bengalski, gudżarati, hindi, kannada, malajalam, marathi, nepalski, odija, pendżabski, tamilski, telugu i urdu. Wyłącznie w piśmie natywnym dostępne są: asamski, bodo, dogri, kaszmirski, konkani, maithili, manipuri, sanskryt, santali i sindhi.
Autorzy podkreślają ważne rozróżnienie: „pismo natywne” odnosi się do systemu pisma, ale tekst wciąż pochodzi z tłumaczenia z angielskiego. „Romanizacja” oznacza tekst w języku indyjskim zapisany alfabetem łacińskim — to nie jest tłumaczenie angielskie, lecz inna forma zapisu tej samej treści. Dla każdego z dwunastu dwuskryptowych języków romanizacja obejmuje podzbiór zaakceptowanych tłumaczeń w piśmie natywnym. Rozróżnienie to ma znaczenie przy konstruowaniu mieszanki treningowej, ponieważ rekordy natywne i zromanizowane dają inną ekspozycję na pismo, mogąc jednocześnie wyrażać tę samą treść merytoryczną.
Sam proces budowy danych opiera się na czteroetapowym potoku zaimplementowanym w NeMo Data Designer: tłumaczenie dokumentów na poziomie całych tekstów, ocena jakości i ukierunkowana naprawa błędów, z zachowaniem elementów takich jak równania, tabele i kod. Liczby tokenów opisują zachowany korpus — łącznie z zaakceptowanymi poprawkami — a nie budżet tokenowy konkretnego treningu modelu, co autorzy wyraźnie zaznaczają jako istotne rozróżnienie metodologiczne.
Znaczenie dla otwartych modeli językowych
Twórcy podkreślają, że publikują nie tylko sam korpus, ale cały przepis na jego generowanie — prompty, przepływy pracy oparte na dużych modelach językowych i mechanizmy kontroli jakości. Dzięki temu zespoły mogą korzystać z korpusu bezpośrednio, dostosowywać prompty i procedury weryfikacji jakości albo wprowadzić do potoku własne dokumenty źródłowe. Tego typu otwartość w budowaniu danych syntetycznych wpisuje się w szerszy nurt debaty wokół korzyści i zagrożeń płynących z otwartych modeli AI, gdzie transparentność procesu bywa równie istotna jak sama dostępność wag modelu.
Dane w pełni naturalnie napisane w językach indyjskich pozostają, zdaniem autorów, niezastąpione dla lokalnej wiedzy i kontekstu kulturowego — syntetyczny korpus ma je uzupełniać, a nie zastępować. NVIDIA zapowiada już wykorzystanie tego zbioru w przyszłych modelach z rodziny Nemotron, a pełny opis techniczny efektów zastosowania danych w modelu Nemotron 3.5 Super VL ma zostać przedstawiony w osobnym raporcie technicznym.
Publikacja Nemotron-pretraining-Indic-v1 wraz z otwartym potokiem generowania danych ma otworzyć drogę do budowy silniejszych modeli językowych obsługujących języki, którymi posługuje się niemal 1,2 miliarda ludzi — i to na zasadach w pełni jawnych oraz możliwych do odtworzenia przez całą społeczność badawczą.
Źródła
Powrót do nawigacji
Podobne Publikacje

Badania i Nauka
Nowy C-test LLM ma zmierzyć superinteligencję AI
Jose Hernandez-Orallo zaprezentował C-test oparty na Kt Levina i LLM, mierzący trudność zadań AI poza zasięgiem najlepszych obecnych modeli.
6 min
Badania i Nauka
RealtimeBench i TORSI: agenci AI uczeni działania pod presją czasu
Nowy benchmark RealtimeBench i metoda TORSI pokazują, że szybkość agentów AI może liczyć się bardziej niż jakość pojedynczej odpowiedzi.
6 min
Narzędzia i Aplikacje
ChatGPT w Chrome: nowa wtyczka czyta karty i wykonuje zadania
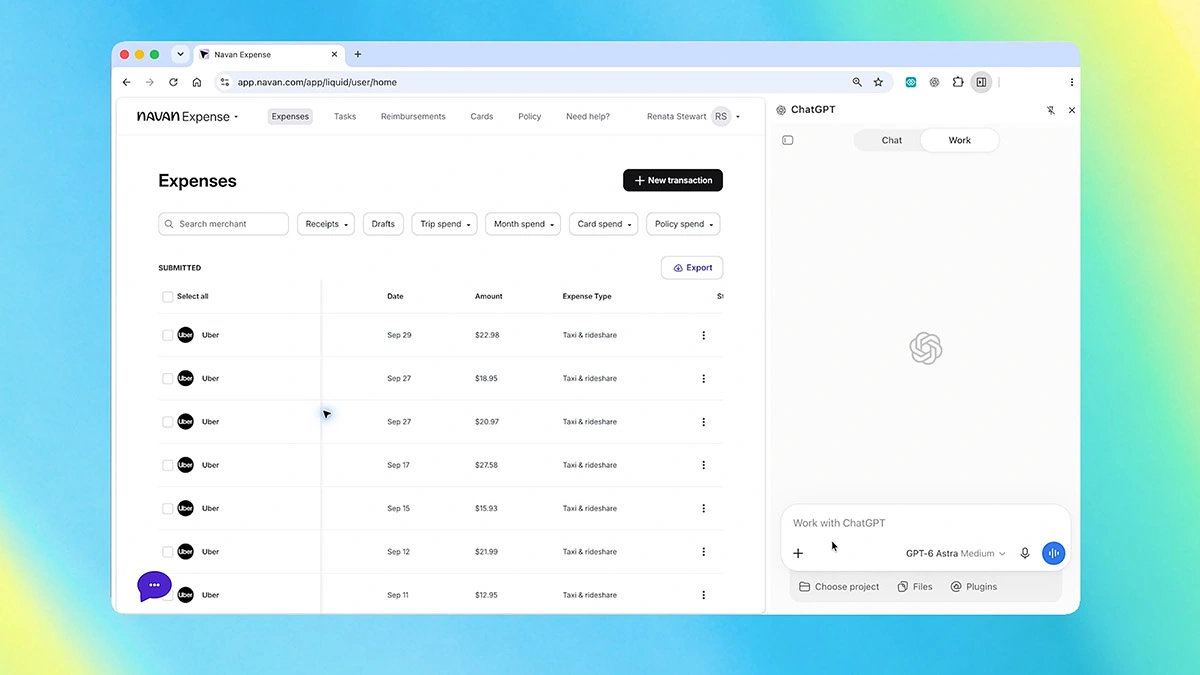
OpenAI rozbudowało wtyczkę ChatGPT do Chrome – chatbot analizuje otwarte karty i samodzielnie wypełnia formularze czy wysyła wiadomości.
5 min