6 min czytania
Claude Sonnet 5.5: Anthropic dogania Opus 5.5 taniej i szybciej
Anthropic wydał Claude Sonnet 5.5 – szybszy o 30%, tańszy o 30% i niemal równy Opus 5.5 na kluczowych benchmarkach programistycznych.
Źródło zdjęcia: Simon Willison’s Weblog
Simon Willison donosi o premierze Claude Sonnet 5.5 – nowego modelu Anthropic, który firma opisuje jako działający „ponad 30% szybciej i kosztujący do 30% mniej przy większości zadań”. Model wyceniono identycznie jak Sonnet 5, ale według Anthropic bije poprzednika na wszystkich benchmarkach, a przy tym powinien być tańszy w praktycznej eksploatacji. Szczegóły techniczne i wyniki testów potwierdza również serwis The Decoder, który jako pierwszy opublikował pełną tabelę porównawczą benchmarków.
Kluczowe wnioski
- Claude Sonnet 5.5 generuje odpowiedzi ponad 30% szybciej i redukuje koszt pojedynczego zadania o do 30% dzięki bardziej efektywnemu wykorzystaniu tokenów – ceny za milion tokenów pozostają identyczne jak w Sonnet 5 (2 USD za wejście, 10 USD za wyjście).
- Na Terminal-Bench 4.0 wynik skoczył z 10,3% do 70,6%, a na GDPval-AA (benchmark oceny pracy wiedzowej) Sonnet 5.5 osiąga 1844 punkty – niemal dorównując flagowemu Opus 5.5 (1846 punktów).
- Model stał się nowym domyślnym silnikiem darmowej wersji claude.ai, co – jak zauważa Willison – daje Anthropic wyraźnie bardziej rozbudowaną bezpłatną ofertę niż darmowy poziom ChatGPT oparty na modelu Luna 5.6 od OpenAI.
- Anthropic zapowiedziało też Claude Haiku 5.5 „w najbliższych tygodniach” – model do zadań o wysokiej przepustowości i niskim koszcie.
- Sonnet 5.5 jest już dostępny na AWS, Google Cloud i Azure, a Anthropic wprowadził nowe zabezpieczenia przed ryzykiem cybernetycznym i atakami typu distillation.
Wyniki benchmarków: blisko Opus 5.5 za ułamek ceny
Największy skok wydajności widać w zadaniach programistycznych. Na Terminal-Bench 4.0, teście kodowania agentowego, Sonnet 5.5 notuje 70,6% wobec 10,3% u Sonnet 5 – i wyprzedza nawet Opus 5.5 (66,4% w najwyższym ustawieniu wysiłku). Na CursorBench 4.0, który odtwarza realne sesje kodowania w edytorze Cursor, model uzyskuje 55,5% wobec 34,1% u poprzednika, zostając tylko dwa punkty za Opus 5.5 (57,8%).
Na FrontierCode 1.1 w ustawieniu „High” Sonnet 5.5 wypada dziesięć punktów lepiej niż Sonnet 5, a koszt zadania jest – według Anthropic – około piętnaście razy niższy. Wczesni testerzy chwalili tempo, z jakim model rozumie strukturę bazy kodu; Sonnet 5.5 częściej też grupuje wywołania narzędzi, co skraca liczbę wymaganych kroków.
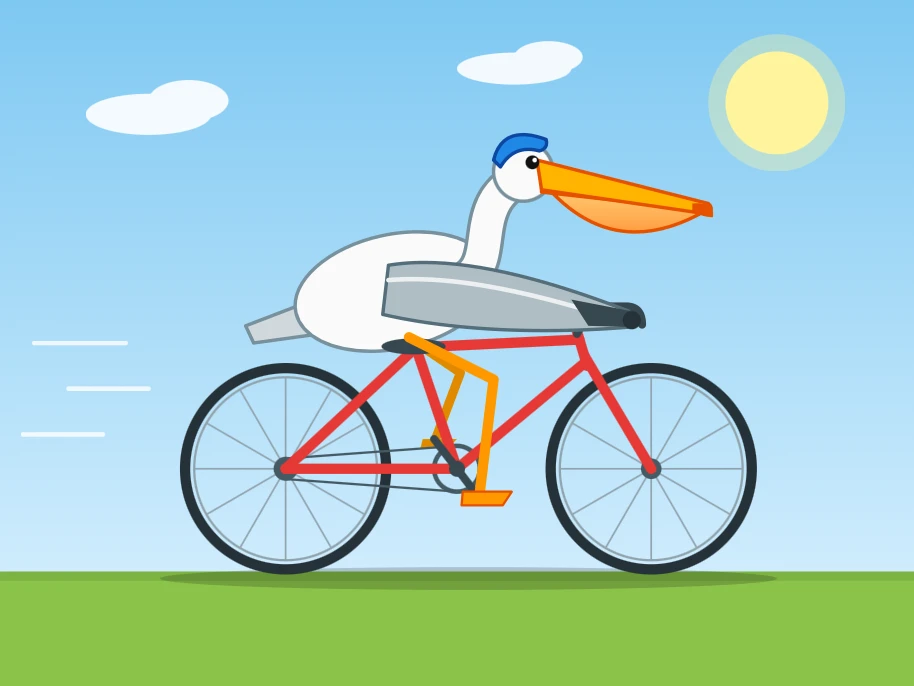
Jest jednak dziwna anomalia: przy najwyższym poziomie wysiłku „Max” model wypada gorzej na FrontierCode niż przy poziomie „Xhigh”. Anthropic wyjaśnia, że przy maksymalnym wysiłku Sonnet 5.5 częściej aktywuje funkcję przeglądu kodu, dzielącą pracę między wiele podagentów – co w niektórych przypadkach prowadziło do przekroczeń czasu lub zmian wykraczających poza zakres zadania, a to obie sytuacje karane przez FrontierCode. Willison zauważył identyczny problem podczas swojego testu „pelikan na rowerze”: przy ustawieniu „max” model myślał przez 128 000 tokenów (za 1,28 USD), by ostatecznie wyczerpać budżet tokenów i nie wygenerować grafiki SVG – ten sam błąd, który wystąpił wcześniej w Opus 5.5. Przy ustawieniu „xhigh” otrzymał jednak działający obrazek pelikana za 5,74 centa i w 41 sekund, a Sonnet 5.5 okazał się – jego zdaniem – „prawie tak dobry jak Opus 5.5” w niektórych zadaniach kodowania, w tym wiralowych trikach animacji 3D.
W zadaniach z zakresu pracy wiedzowej różnice na korzyść Opus 5.5 są minimalne. Na GDPval-AA v2.1, benchmarku opracowanym przez OpenAI i obejmującym zadania z 44 profesji i dziewięciu branż, Sonnet 5.5 zdobywa 1844 punkty wobec 1846 u Opus 5.5 i tylko 1449 u Sonnet 5. Model GPT-6 Sol od OpenAI, według danych Anthropic, osiąga w tym teście 1487 punktów. Na AA Briefcase v1.1 Sonnet 5.5 notuje 1811 punktów (Opus 5.5: 1822, Sonnet 5: 1359, GPT-6 Sol: 1483). Na Chartography, teście rozpoznawania wykresów wizualnych, wynik skoczył z 15,6% do 61,6% (Opus 5.5: 64,4%, GPT-6 Sol: 53,6%). Na Humanity's Last Exam z narzędziami Sonnet 5.5 osiąga 64,5% wobec 54,9% u Sonnet 5 i 67,7% u Opus 5.5, a na OSWorld 2.1 (ocena częściowa) – 80,1% wobec 57,0% i 81,8% odpowiednio.
Wczesni testerzy opisywali Sonnet 5.5 jako bardziej naturalnego rozmówcę z wyczuciem estetyki – model potrafi przebudować interfejs użytkownika czy wykonać szablon prezentacji tak dobrze, że rezultaty wymagają jedynie kosmetycznych poprawek, jak twierdzi Anthropic. Firma podaje też, że Sonnet 5.5 jest pierwszym modelem z rodziny Sonnet, który przechodzi grę Pokémon Red korzystając wyłącznie z zrzutów ekranu – podobny postęp na benchmarkach growych pokazał niedawno model Astra od OpenAI. Zadania tego typu jeszcze kilka lat temu uznawano za trudne i wymagające dedykowanych algorytmów; teraz radzą sobie z nimi nawet modele średniej klasy w ramach jednej rodziny produktowej.
Wojna cenowa i darmowa oferta Anthropic
Sonnet 5.5 kosztuje tyle samo za milion tokenów co jego poprzednik: 2 USD za tokeny wejściowe, 10 USD za tokeny wyjściowe i 0,20 USD za odczyty z cache. Ponieważ model wykorzystuje mniej tokenów na zadanie, efektywny koszt spada – według Anthropic – nawet o 30%, a generowanie odpowiedzi jest ponad 30% szybsze. Niezależne testy nie potwierdziły jeszcze tych deklaracji.
Dla porównania, Opus 5.5 kosztuje 4 USD za tokeny wejściowe i 20 USD za wyjściowe, podczas gdy konkurencyjny GPT-6 Sol od OpenAI wycenia te same operacje na 2 i 10 USD. Darmowy model OpenAI, GPT-6 Luna, jest znacznie tańszy – 0,10 USD za wejście i 0,50 USD za wyjście – ale też wyraźnie słabszy. To istotne, bo darmowa wersja claude.ai korzysta obecnie z Sonnet 5.5, podczas gdy darmowy poziom ChatGPT działa na modelu Luna 5.6. Willison przetestował to osobiście, prosząc darmową wersję Claude o zbudowanie strony HTML renderującej trójwymiarowego pelikana na rowerze w WebGL – i ocenił efekt jako „solidny wynik”.
Z modelami Fable, Opus i Sonnet Anthropic ma teraz odpowiedniki dla wszystkich trzech modeli GPT-6 od OpenAI: Astra, Sol i Luna, co – jak zauważa The Decoder – zapoczątkowało najnowszą wojnę cenową w branży. W przybliżeniu Opus jest odpowiednikiem Sol, Sonnet – Luna, a Fable – Astra, choć Anthropic wycenia swoje modele wyżej na całej linii. Różnice wydajności między odpowiadającymi sobie poziomami są tak niewielkie, że o wyborze może decydować przede wszystkim koszt. Zapowiedziany Haiku 5.5 ma pomóc Anthropic zniwelować tę różnicę cenową – Willison napisał wprost, że liczy na to, by ten model był „cenowo konkurencyjny z GPT-6 Luna”.
Model jest już dostępny na AWS, Google Cloud i Azure, a Anthropic dodał nowe zabezpieczenia przeciwko ryzyku cybernetycznemu i atakom typu distillation, co wskazuje na rosnące obawy branży wokół możliwości nadużycia coraz bardziej zdolnych modeli agentowych.
Claude Sonnet 5.5 pokazuje, że dystans między modelami średniej i najwyższej klasy szybko się zacieśnia – Anthropic oferuje niemal wydajność flagowego Opusa za ułamek ceny, jednocześnie wzmacniając darmową ofertę claude.ai wobec konkurencji ze strony OpenAI.
Powrót do nawigacji
Podobne Publikacje

Etyka i Bezpieczeństwo
Wicegubernator NJ: AI potwierdziła, że nie molestowałem
Dale Caldwell zrezygnował po dochodzeniu w sprawie molestowania, ale twierdzi, że chatboty AI 59 razy potwierdziły jego niewinność.
4 min

Narzędzia i Aplikacje
Gemini może dzwonić za ciebie do bliskich z krótką wiadomością
Android Authority odnalazło w kodzie APK dowody na rozszerzenie funkcji Call for Me w Gemini na rozmowy z rodziną i znajomymi.
4 min
Etyka i Bezpieczeństwo
Sondaż: Amerykanie chcą spowolnić lub zatrzymać rozwój AI
Sondaż Quinnipiac pokazuje, że większość Amerykanów chce spowolnienia rozwoju AI i nie ufa liderom branży technologicznej.
5 min